
模型为什么要把句子切成碎片?BPE分词算法一步步拆解
你用中文输入"今天天气不错",模型看到的并不是这六个字。它拿到手的,是一串整数——每个整数对应词表里的一个 token,而一个汉字在多数主流模型里会被拆成两到三个 token。也就是说,你和模型之间隔着一个分词器,它负责把你写的话翻译成模型能读的数字序列。
这个分词器怎么决定"切多碎"?为什么同样是中文,不同模型的一个字占的 token 数不一样?这些问题的答案,都在 BPE(Byte Pair Encoding,字节对编码)这套算法里。这篇用一个具体例子,把它从头走一遍。
分词的难点在于:总会有没见过的词
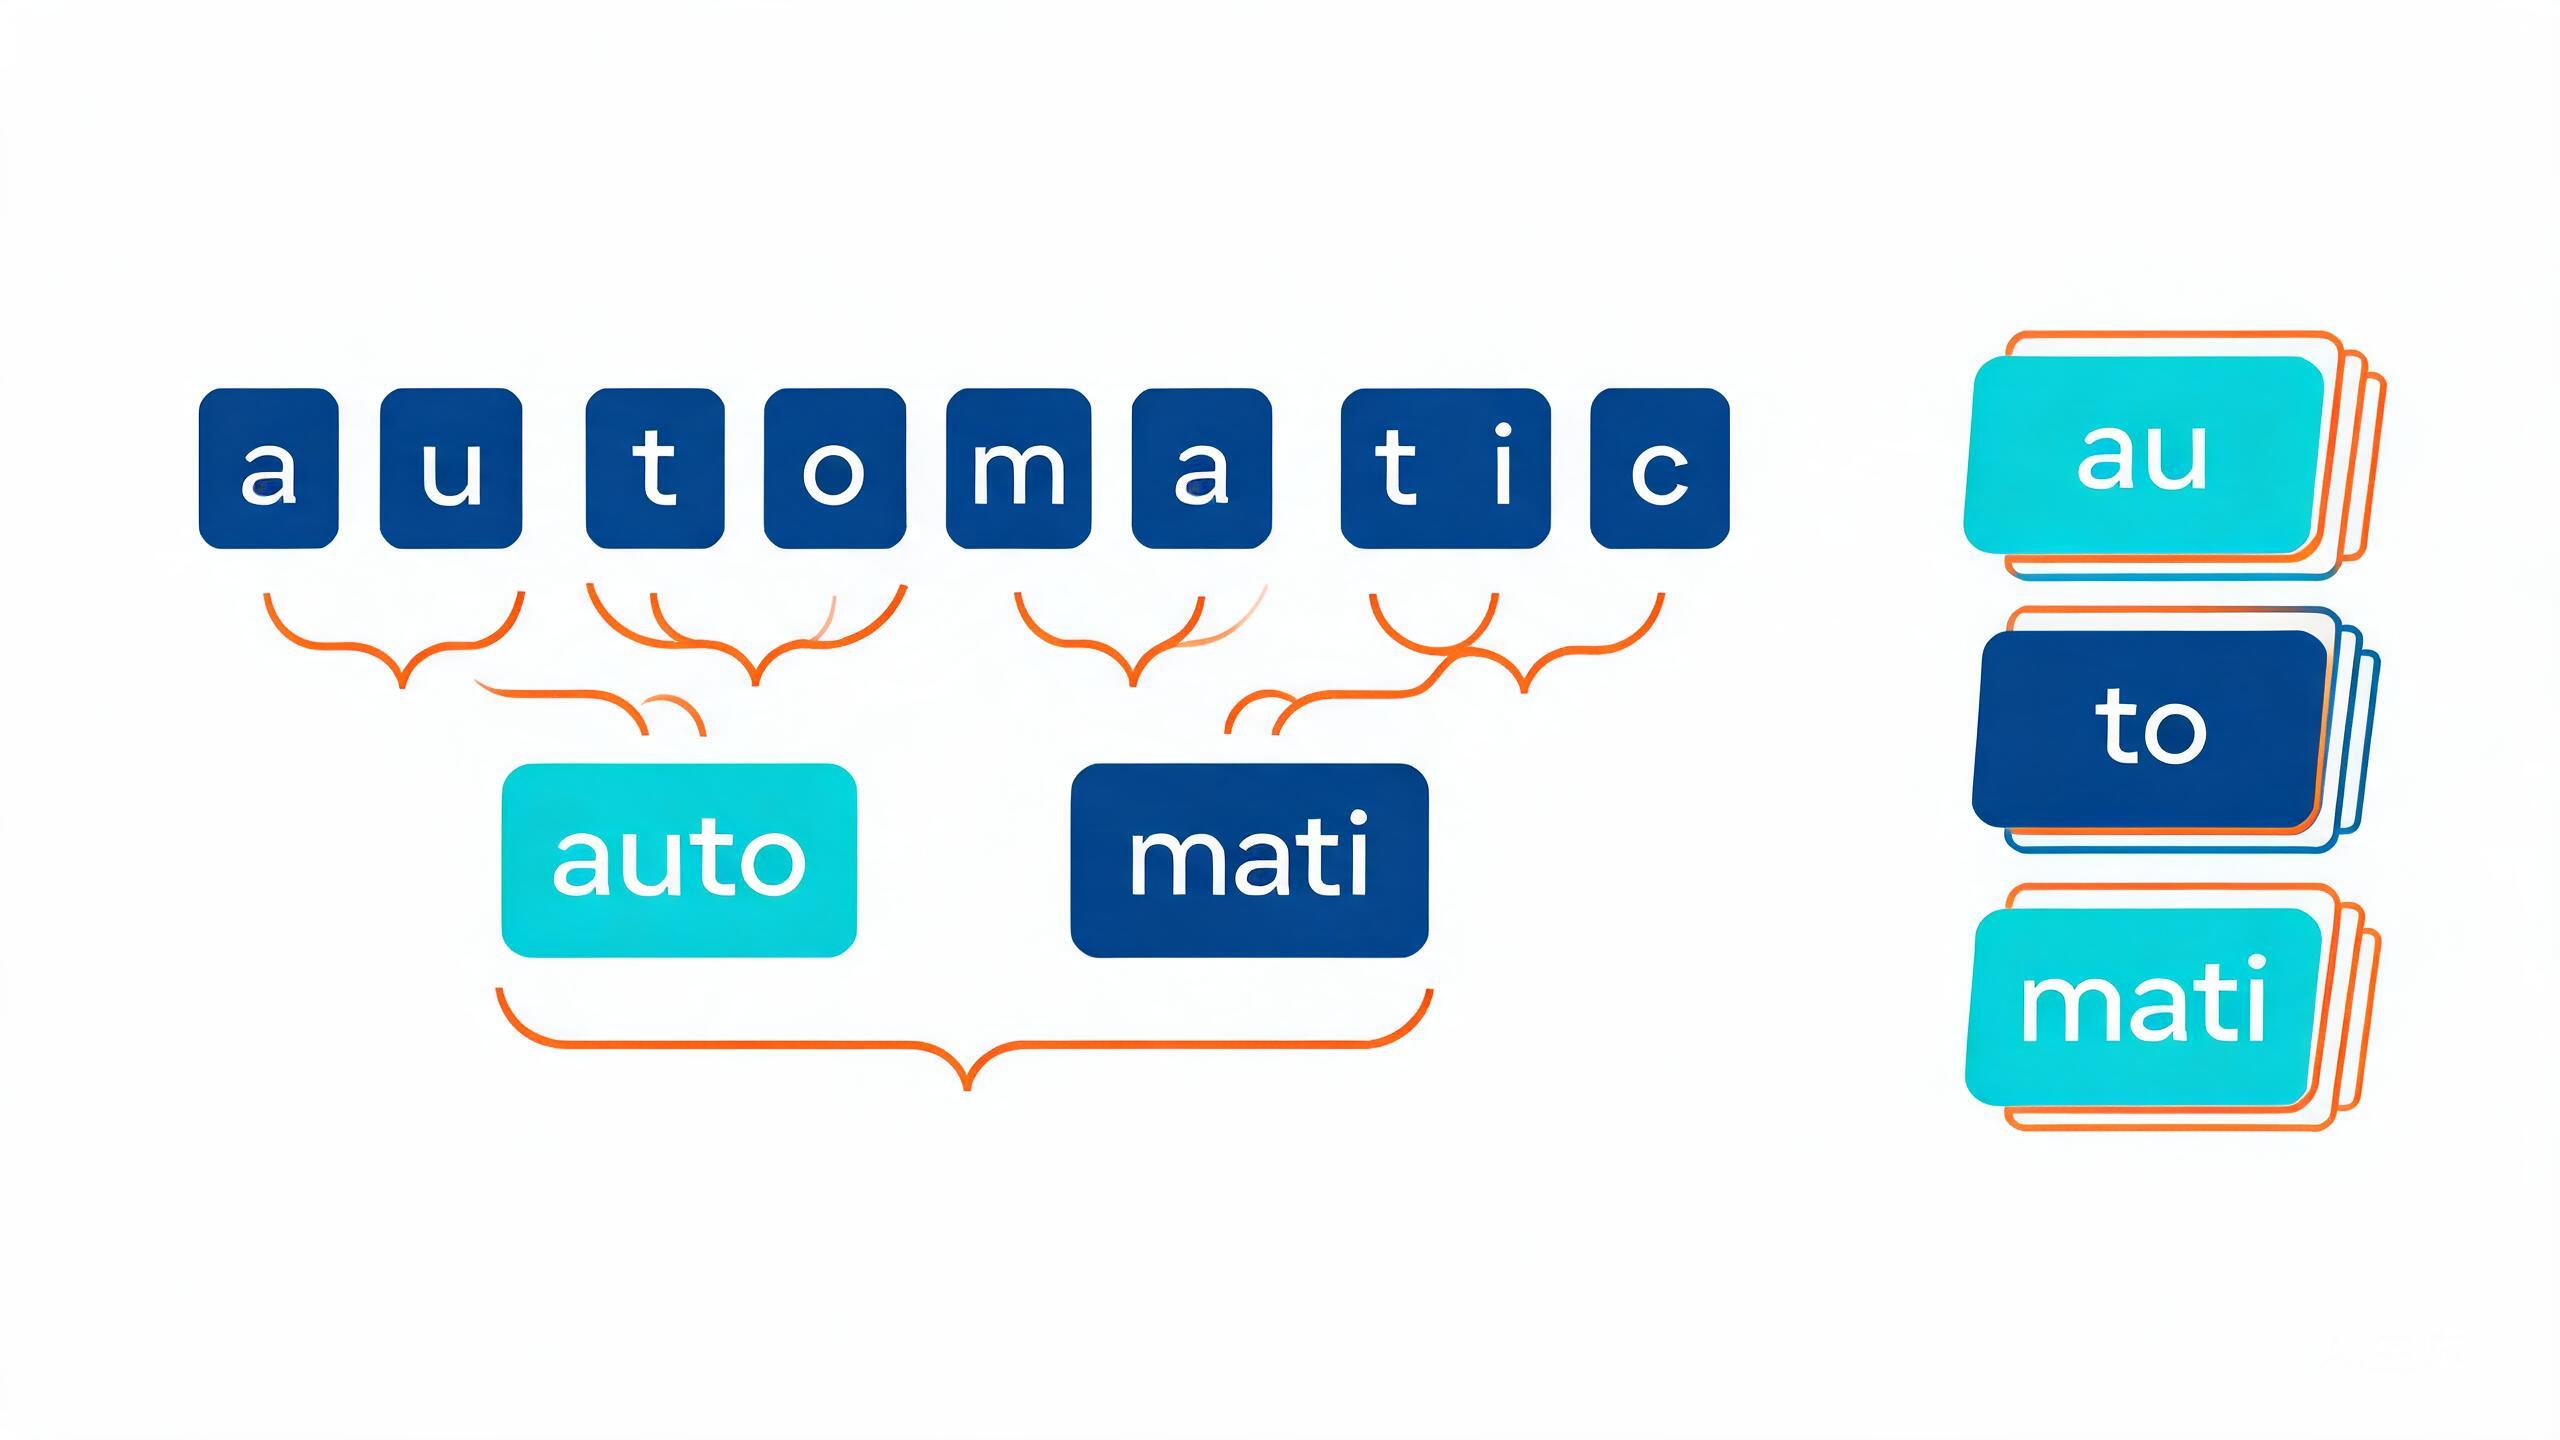
分词的朴素想法是"按词表切"——手里有一张词典,遇到一个词就查一下。问题在于,语言是开放的,你永远没法事先列全所有词。人名、新造的缩写、带错拼写的输入、今天刚出现的网络热词,都会让"查词典"这条路撞上墙。
按字符切倒是不会漏——再陌生的词也能拆成一个个字符。但字符的粒度太细,一个词被拆得七零八落,模型要花好几个 token 才能表达一个常见词,序列变长,训练和推理的成本都上去了,语义也不够凝练。
按词切会有"词表外"问题,按字符切又太碎。BPE 要在两者中间找一个平衡点:既能覆盖任何输入,又让常见词尽量用一个整块来表示。它的做法,是从字符出发,把高频相邻字符逐步合并成更大的块。
从字符出发,反复合并高频对
BPE 的开局很简单:词表里装着所有基础符号,通常就是一个个字符(字节级 BPE 则是一个个字节)。然后它做一件事——统计语料里相邻符号成对出现的次数,把出现次数高的那一对合并成一个新符号,写进词表。重复这个过程,合并次数达到预设上限就停。
每次合并,都在词表里新增一个"由两个旧块拼成的新块";下次统计时,这个新块又能和别的块继续合并。层层往上,词表里就会长出 "es"、"est"、"low" 这样的常见片段。
用一个经典的例子演示,会清楚很多。假设语料里只出现这样几组数据(数字是出现次数):
low    出现 5 次
lower  出现 2 次
newest 出现 6 次
widest 出现 3 次
起步时,词表是这些字符的集合:l、o、w、e、r、n、s、t、i、d。然后开始统计相邻字符对的出现次数。把每个词按字符展开,比如 "low" 展开成 l-o-w,"newest" 展开成 n-e-w-e-s-t,再数每对相邻字符一共出现了几次。统计下来,出现次数比较高的几对是这样的:
(e, s) 出现 9 次   —— newest 里 1 次 + widest 里 1 次,共 6+3
(s, t) 出现 9 次
(l, o) 出现 7 次
(o, w) 出现 7 次
(e, r) 出现 2 次   —— 只在 lower 里
统计出来的候选里,(e, s) 和 (s, t) 各出现 9 次,并列排在前面。取先遇到的那个 (e, s),把它合并成新符号 "es",写进词表。语料里的 "newest" 就变成了 "new" + "es" + "t","widest" 变成 "wid" + "es" + "t"。下一轮统计,(es, t) 这对出现了 9 次,合并成 "est"。再往后 (l, o) 合并成 "lo",(lo, w) 合并成 "low"。
几轮下来,词表里多出了 "es"、"est"、"low" 这些块。这时 "newest" 就被切成 "new" + "est","lowest"(假如语料里有)是 "low" + "est","lower" 是 "low" + "er"。常见的词被拼成了紧凑的整块,而生僻词仍然能退回到更小的块,不会查不到。
训练分词器和用它切词,是两件事
BPE 分"训练"和"编码"两个阶段,别混在一起看。
训练阶段,是在词表里长出一张"合并规则表"。每发生一次合并,就把那对旧块记下来,按顺序排好。顺序很重要——它是合并的优先级,训练完成后编码时严格按这个顺序走。
编码阶段,是用这张规则表去切一个词。对于一段新文本,先把它拆到底(字符或字节),然后从头扫这张规则表:只要当前序列里存在能合并的相邻对,就按规则顺序把它拼起来,扫到再没有可合并的对为止。扫完之后剩下来的那些块,就是这个词的 token 序列。
用伪代码写,训练和编码各长这样:
# 训练:从语料统计里长出合并规则
vocab = 所有基础字符
merges = []
while len(merges) < 目标合并次数:
    pair = 语料里出现次数更多的相邻符号对
    merges.append(pair)          # 按顺序记录合并规则
    vocab.add(pair[0] + pair[1]) # 新块进入词表
    用合并后的形式重写整个语料

# 编码:按规则顺序贪心合并
def encode(word):
    syms = list(word)            # 先拆到底
    while True:
        # 按 merges 的顺序,找头一对能合并的位置
        i = 按顺序满足 (syms[i], syms[i+1]) in merges 的下标
        if i 不存在:
            break
        syms[i] = syms[i] + syms[i+1]
        del syms[i+1]
    return syms
encode 里那句"按 merges 的顺序找,而不是按当前位置随便找",是编码阶段容易写错的地方。合并规则有固定的优先级,编码时必须严格遵循,否则同一个词可能切出不同的结果。
字节级 BPE:把所有字符都兜住
字符级 BPE 用字符当基础符号,理论上任一 Unicode 字符都能进词表。但 Unicode 字符有几万个,想把它们的各种组合都覆盖住,词表会膨胀,很多字符也只是偶尔出现、占了位置。
字节级 BPE 换了个更底层的起点:基础符号不是字符,而是字节。一段文本先被编码成 UTF-8 的字节序列——这里只有 256 种可能的字节——再在这个字节序列上做 BPE 合并。
这样做有两个直接的好处。一是词表里不再有"没见过的字符"这回事,任何输入都能落到 256 个字节的组合里,词表外这个词几乎不存在了。二是 256 这种小基数,让合并能从很小的空间开始,常见字节串(对应常见字符或词片段)会被充分合并成整块。
GPT 系模型用的就是字节级 BPE:词表大小 50257,其中基础字节占了 256 个,剩下的是合并出来的约五万个子词。
为什么中文在字节级 BPE 下会吃亏
字节级 BPE 对英文很友好,对中文却有个绕不开的问题:一个汉字在 UTF-8 里占 3 个字节。BPE 合并需要语料里有足够的共现频率,才能把这三个字节"焊"成一个整块;对于低频汉字或生僻字,它们常常焊不起来,就只能以两到三个分立的 token 存在。
结果是同一个意思,中文需要的 token 往往比英文多。一段相同含义的文本,英文可能 100 个 token 就说完了,中文可能要 150 个甚至更多。这个差距会直接传导到成本和速度上——计费按 token 算,生成速度也受序列长度影响。
这也是为什么中文大模型会花心思在分词上:有的直接针对中文词表做优化,有的在字节级 BPE 之外对高频汉字做单独处理。分词这一层虽然不起眼,在中文场景下对成本和效果的影响远比很多人以为的大。
分词器的坑,模型再强也补不回来
分词器有个容易被忽视的性质:它是模型所有能力的地基,但它的很多决策是"硬"的,模型没法绕过。
一个典型的表现是数字和大小写。同样一个数字 "12345",可能某次被切成 "123"+"45",另一次上下文不同又被切成 "12"+"345",模型在做算术题时,要先去理解这些被切碎的片段对应同一个数。再比如空格和标点:分词器把标点独立切开、还是跟前面的词粘在一起,都会悄悄影响模型对边界的判断。
所以排查一个文本模型"为什么这里理解不对"时,除了看模型本身,也值得把输入丢进分词器,看看它到底被切成了什么样。很多看起来像"模型不懂"的现象,翻开 token 那一层,答案其实早就摆在那了。
小结
BPE 解决的是分词里那个两难:按词切会遇上词表外,按字符切又太碎。它的办法是从字符(或字节)出发,反复合并语料中出现频率高的相邻对,在词表里长出 "es"、"est"、"low" 这样的常见块。训练阶段产出带优先级的合并规则,编码阶段严格按规则贪心合并,把任何新词都切成词表里的已知块。
到了字节级 BPE,基础符号压到 256 个字节,词表外问题基本消失,但中文因为"一个字占三个字节"而付出额外的 token 成本。理解分词器到底做了什么、为什么这么切,是用好文本模型之前值得补的一堂课。
