
为什么大模型参数这么多却不太慢?MoE 混合专家架构原理拆解
这几年有个奇怪的现象:有的模型总参数大得吓人,跑起来却没想象中那么慢,训练成本还压得很低。背后的关键,很多时候就是"MoE"这三个字母——混合专家(Mixture of Experts)。
MoE 这几年因为 DeepSeek 被推到台前,但它不是新东西。这篇拆它的架构:为什么"参数变大、算力却不跟着变大",中间的"稀疏激活"到底是怎么做到的,以及它为此付出什么代价。
稠密模型的路越走越窄:每个 token 都要过全部参数
先看传统的大模型结构。标准的 Transformer 里,前馈层(FFN)占了大头,模型参数主要堆在这里。所谓"稠密"(Dense)模型,指的是:每来一个 token,它都要把这套前馈层的所有参数都过一遍,参数是全量激活的。
这就带来一个两难:想让模型更强,就往里堆更多参数;但参数一多,每个 token 的计算量跟着涨,推理变慢、训练变贵。参数规模和算力成本死死绑在一起,能力的天花板被算力卡住。
MoE 想干的,就是把这两者解绑。
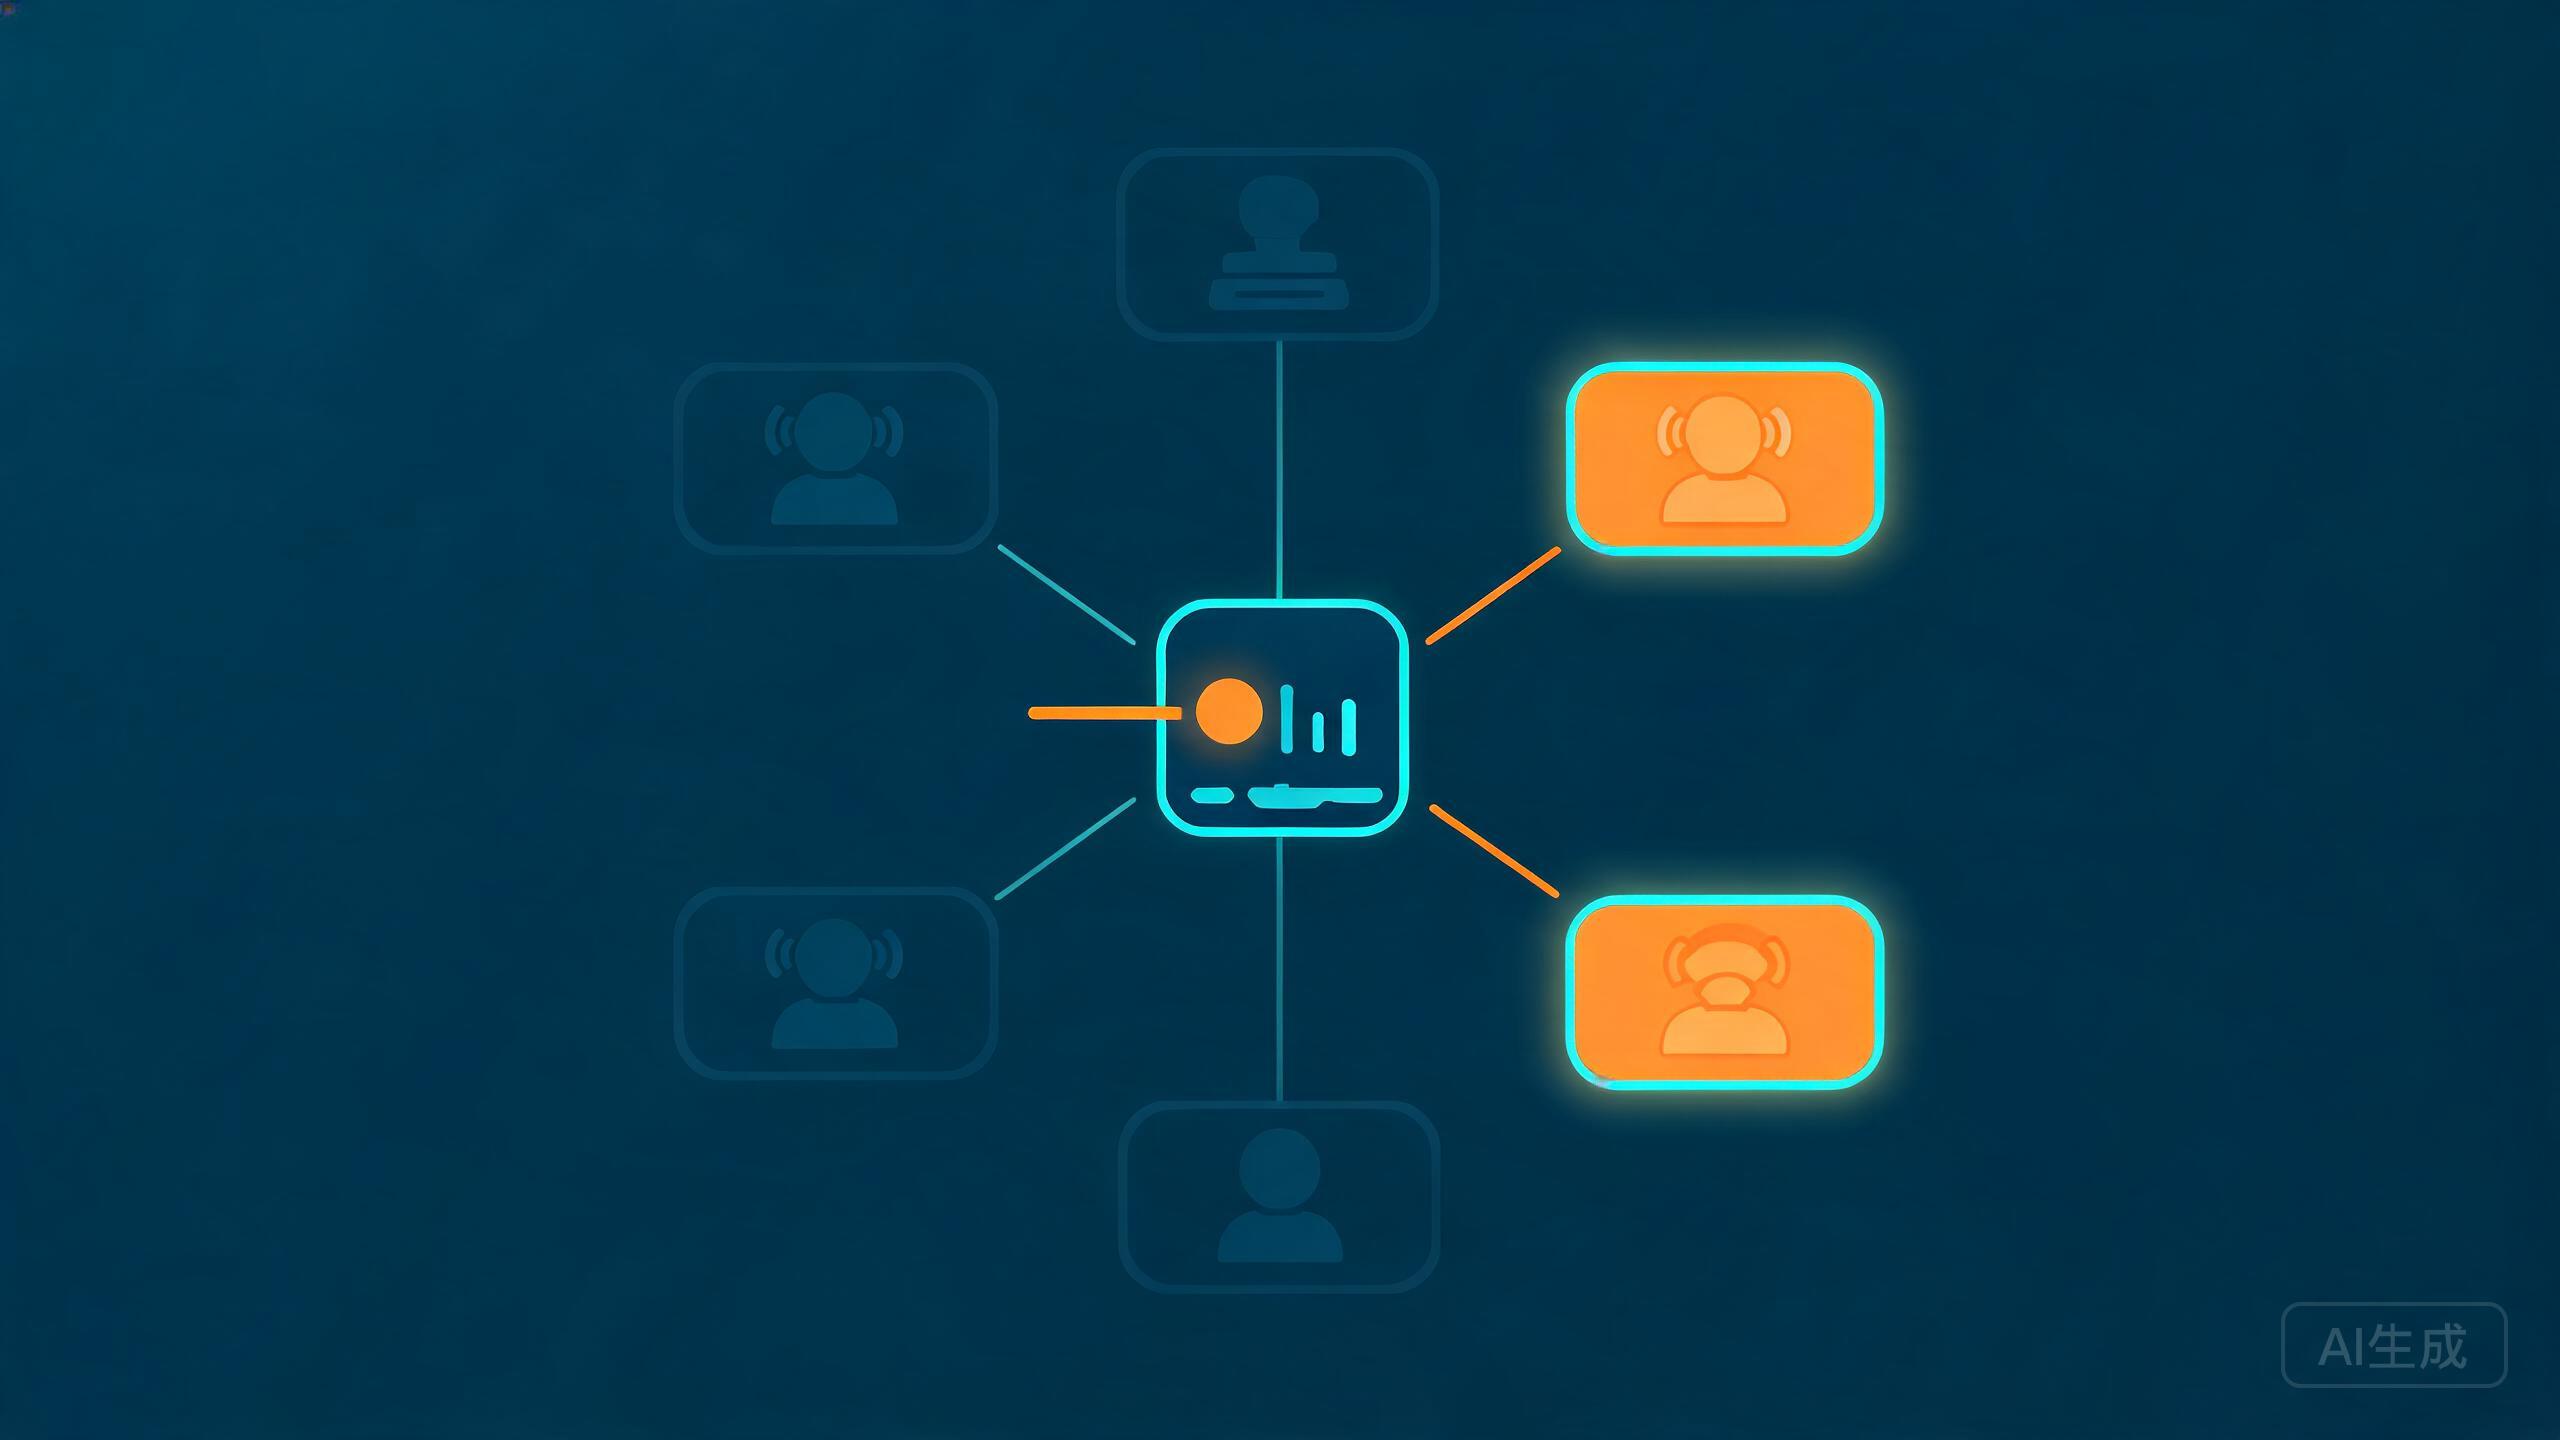
MoE 的巧:只点亮少数「专家」
MoE 的做法,是把前馈层从"一个大网",改成"一排并列的小网"。这些小网,各自是一个独立的前馈网络,被叫做"专家"(expert)。
关键在这个"只点亮少数":来一个 token,不是让所有专家都参与,而是由一个门控网络(也叫路由器,router/gate)先算一圈,挑出当前 token 更该走的少数几个专家(常见 top-2,即激活两个),只有这几个专家被真正计算,其余专家原地待命。
这么一改,参数和算力就分家了:专家的总参数可以铺得很开(比如有几十上百个专家,总参数量轻松上千亿),但单个 token 实际只激活其中两个,算力跟一个"总参数只有激活部分那么大"的模型差不多。
门控是怎么挑专家的
门控网络本身也是个小的线性层加 softmax:进来一个 token 的表征,它给每个专家打一个分数,归一化成概率,再选概率高的那 k 个。
简化后可以这么想:
scores = softmax( W_gate · h )     # 每个专家一个分数
topk   = 取 scores 排在前 k 的专家
out    = Σ 分数ᵢ × expertᵢ(h)       # 只在这些专家上算,再按分数加权求和
这个 token 的输出,是那几个被选中专家的结果按门控分数加权得来的。没被选中的专家,这轮完全不出力——这正是"稀疏激活"的来源。
顺带说一句"稀疏"到底省在哪:省的不是内存,是计算量。所有专家的权重都还得装下,参数一多,显存或存储照样涨;真正省下的是每个 token 要做的乘加运算量,因为只算了少部分专家。
稀疏激活的好处,和它埋下的三个坑
好处很直接:在算力几乎不变的前提下,把模型容量(参数量)做大,训练和推理的单 token 成本都压下来。
但稀疏激活不是白捡的,它带来了几个专属难题。
一是负载均衡。理想情况是每个专家被选中的机会差不多。现实是门控容易偷懒——训着训着,大多数 token 都往少数几个"热门专家"挤,别的专家闲置。结果热门专家过载、冷门专家浪费,容量优势打了折扣。
二是路由塌缩。更糟的情况是,如果门控把所有 token 都路由到同一个专家,MoE 就退化成一个普通稠密层,等于白搭。
三是训练不稳定。门控是离散的"选或不选",梯度怎么传、专家怎么均衡更新,都比稠密模型难伺候。
应对的办法常见有这样几味:加一个辅助的负载均衡损失(aux loss),训练时惩罚"专家分配太不平均"的情况;再给门控分数加点噪声(noisy top-k)让路由更愿意探索;有时再设一个容量上限,防止某个专家一口气吞下太多 token。
DeepSeek 的改进:更细的专家 + 共享专家
把 MoE 带火的 DeepSeek,在这套框架上做了自己的文章,核心是两个改动。
一是细粒度专家的分割。传统专家又大又少,DeepSeekMoE 改成更多、更小的专家,让每个专家更专、颗粒更细。这样做的好处,是专家之间的知识分得更开,激活组合也更灵活,提升专家利用率。
二是共享专家(shared experts)。除了路由选择的专家,再设一批"默认总是激活"的共享专家,用来承接那些通用的、底层的知识。路由专家处理差异化的活,共享专家兜住公共的底,路由压力就小了不少。
这套思路落到 DeepSeek-V2、V3,再到 R1,让它在推理和训练成本上做出了很亮眼的账,也让 MoE 从论文里的小众技巧,变成了人人都想学一手的架构。
小结
把 MoE 收一下:稠密模型的问题是参数和算力绑死,能力被算力卡住;MoE 用"一排专家 + 门控路由 + 只激活 top-k"把两者解绑,靠稀疏激活实现"参数量做大、单 token 算力不变";代价是负载均衡、路由塌缩、训练不稳定三个坑,靠辅助损失、噪声门控、容量上限来填;DeepSeekMoE 再用细粒度专家和共享专家,把专家利用率和成本账做得更漂亮。
理解了这套"少数专家替全班干活"的结构,再看那些"总参数吓人、跑起来却挺轻快"的模型,就能心知肚明——大,是容量的大;快,是激活的少。两者能在 MoE 里同时成立。
