
同样一句提示词,为什么有的图糊有的图艳?CFG引导强度的原理拆解
用文生图工具画一张图,调参数时你多半遇到过这么个滑块:写的是"引导强度"或"CFG Scale",默认值常常卡在 7 上下。把它往小拉,画面变得发散、糊、跟提示词对不太上;往大拉,画面一下子鲜艳浓烈起来,但颜色开始过饱、边缘发黑、构图也变得僵硬。
这个滑块背后管着的东西,叫 Classifier-Free Guidance(无分类器引导,简称 CFG)。它是文生图模型里一个不起眼却影响巨大的机制,直接决定画面"听不听话"和"好不好看"之间的平衡。这篇把它背后的原理讲清楚。
扩散模型从噪点出发,条件怎么进去
先补一句背景。扩散模型生成图像,是从一团随机噪点开始,一步步往回"去噪",慢慢变出一张清晰的图。每一步去噪,模型要根据当前的带噪图和一个额外条件——在文生图里就是那句提示词——来预测该去掉多少噪点。
问题是,条件喂进去的方式,直接决定了它"听不听话"。如果把提示词的编码简单地和噪点图拼在一起送进模型,模型确实能用到条件,但用得够不够、会不会被无视,是另一回事。很多早期模型生成的结果跟提示词关系若即若离,问题的根子就在这里。
要让模型更"听话",一个自然的想法是:显式地告诉它,往哪个方向走更符合条件。
分类器引导:借一个分类器指出方向
早期的引导方案,走的是"借外力"的路子——训练一个额外的分类器。
这个分类器吃进一张带噪的中间图,判断它符不符合某个类别或属性。生成时,每一步去噪除了按扩散模型走,还要叠加分类器给的一个梯度项——它指向"更高概率属于目标类别"的方向。数学上,就是在采样时把 log p(y | x_t) 的梯度加进噪声预测里,其中 y 是条件,x_t 是当前带噪图。
这个方向是对的,效果也不错,但它有两个麻烦。一是要额外训练一个分类器,还得能处理带噪的中间图——普通在干净图上训练的分类器不能直接用。二是把梯度塞进采样循环里,计算和调试都更复杂。
于是有了一个反问:能不能不要这个分类器,靠扩散模型自己完成引导?这就是 CFG 的出发点。
CFG:用同一个模型,走两条路
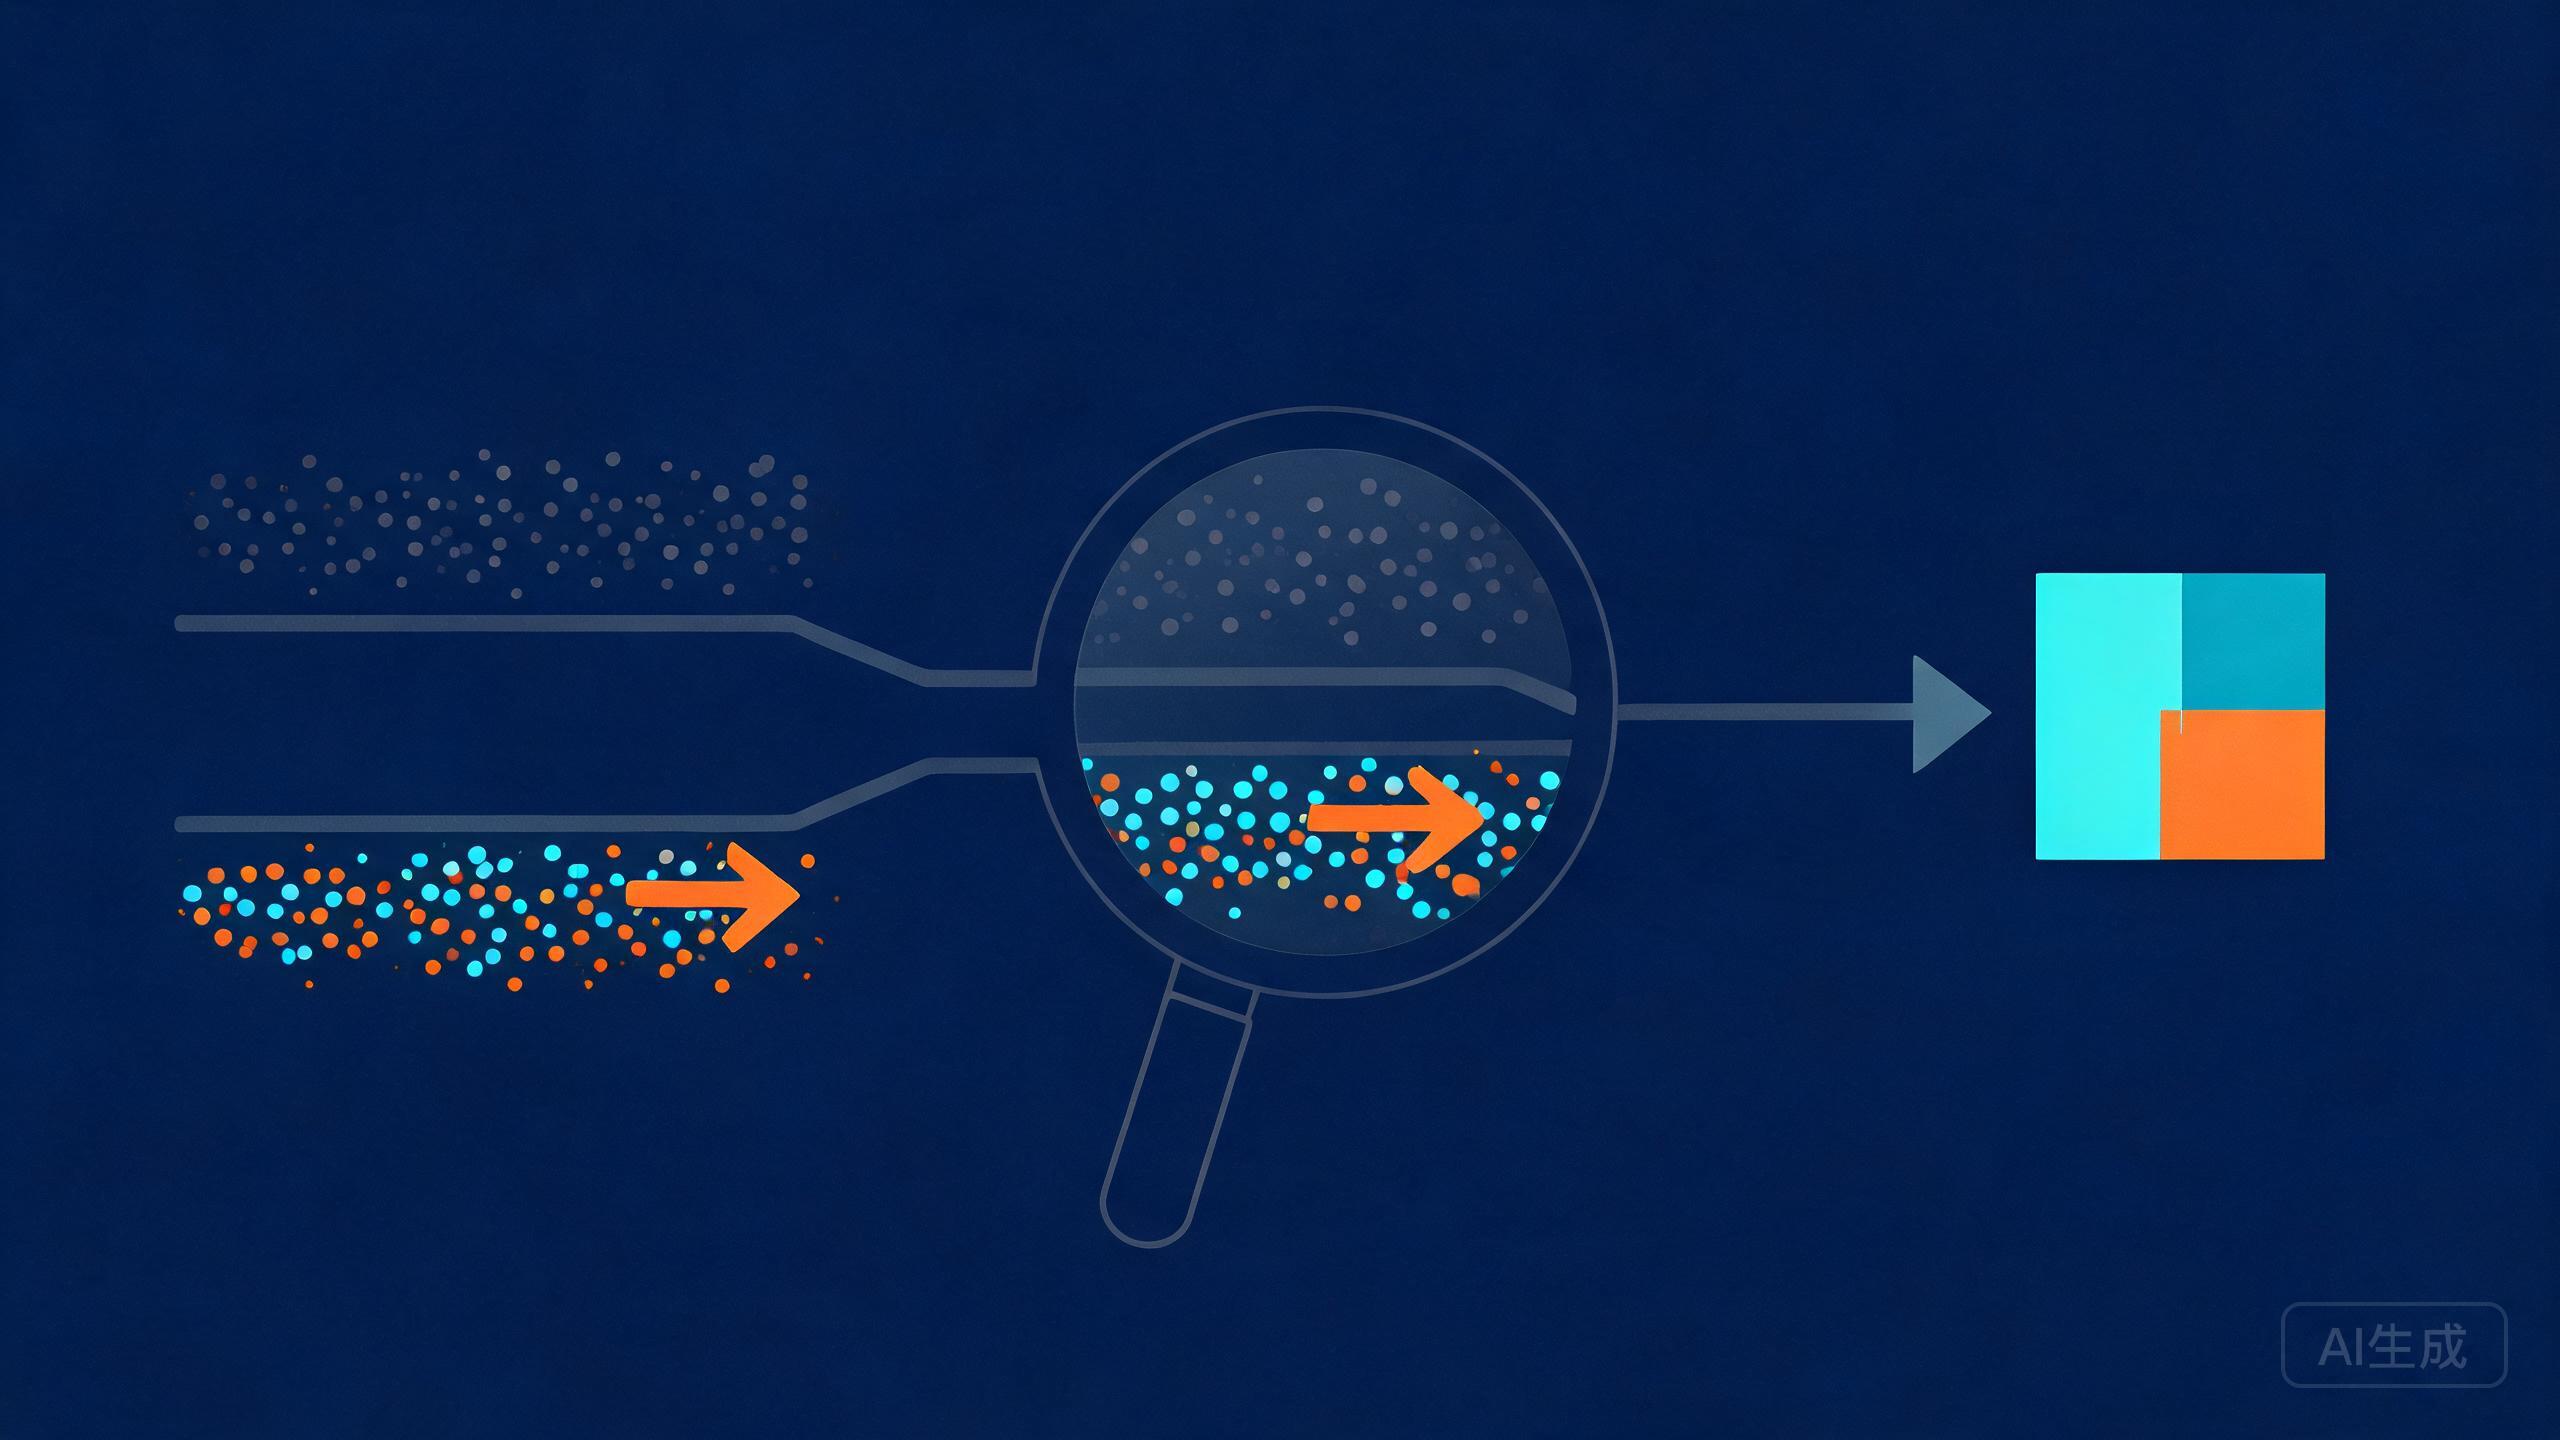
CFG 的核心思想很小,小到一句话就能说清:同一个模型,一次带条件、一次不带条件地各算一遍,用两条结果之间的"差"来放大条件的指向。
具体做法分训练和采样两步。
训练时,模型不是总拿到完整提示词。训练过程中,以一定概率(比如 10%)把提示词替换成一个"空条件"——一个不代表任何内容的占位符。这样模型就同时学会了两种去噪:一种在有条件时怎么去,一种在完全没有条件时怎么去。
采样时,每一步都算两遍:一遍带真实提示词,一遍带空条件。拿到两个噪声预测,然后做一次线性外推:
ε̂ = ε(x_t, ∅) + s · ( ε(x_t, y) - ε(x_t, ∅) )

其中:
  ε(x_t, ∅)   空条件(无条件)的噪声预测
  ε(x_t, y)   带条件 y 的噪声预测
  s           引导强度,就是那个 CFG Scale
把这个式子拆开看会很清楚。前面的 ε(x_t, ∅) 是"无条件基线";括号里做差之后剩下的那一项,是"条件预测比无条件预测多出来的那一部分",也就是条件真正贡献的增量。s 是给这个增量乘的系数。s 等于 1 时,两个条件项的贡献正好抵消一部分,结果就是普通的条件预测;s 越大,条件的增量就被放大得越多,生成的图像就越往"符合提示词"的方向靠。
为什么"差值乘以系数"能起到引导作用
光看公式还容易晕,放到几何直觉里说。
带条件的预测和无条件的预测,两个向量各自指向一个"去噪方向"。它们之间的差,代表"条件把方向往哪边掰了多少"。把这个差按 s 倍放大,再叠回无条件的方向上,相当于沿着"条件指向的方向"往前多走了一段。
这个动作在效果上,等价于把采样过程往"高密度、且更符合条件"的区域推。s 越大,推得越狠,画面就越是贴着提示词走。
但推得太狠也有副作用。一方面,外推可能把采样点推到数据分布之外,画面出现过饱和、锐化过度、边缘发黑这种"用力过猛"的痕迹。另一方面,引导越强,样本的多样性越低——你拿到的不再是"符合条件的一类图"里的随机一张,而越来越往一张被条件钉死的"标准答案"上靠,构图容易雷同。
s 的取值,是一笔平衡账
理解了上面的逻辑,那个默认值 7 就好解释了。它不是一个魔法数,而是"足够听话"和"没那么失真"之间的一条经验折中线。
s 太小,条件几乎不起作用,画面发散,常常生成一些跟提示词无关的东西;s 适中,画面既贴合提示词,又保留一定的自然变化和细节;s 太大,饱和度、对比度被顶上去了,画面看着"很 AI",边缘发黑、细节失真,多样性也塌了。
不同类型的模型对 s 的敏感区间还不一样。有些模型默认 7 很合适,有些模型默认给 3 到 5 效果更好,还有些专门训练过的模型在某个小区间里波动明显。这也是为什么你会看到不同工具、不同模型的推荐值不尽相同——它不是个通用常数,而是和模型训练时的条件丢弃概率、数据分布都绑在一起的。
小结
把 CFG 这条线串起来:扩散模型去噪时,条件如果不显式引导,模型可能"不太听话";分类器引导用外部分类器的梯度来指方向,有效但麻烦;CFG 换了个更省事的思路——训练时随机把条件替换成空条件,让同一个模型学会"有条件""无条件"两种去噪,采样时用两者的差、按引导强度 s 放大,把条件的方向放大出来。
那个滑块,调的本质就是 s 这一个数。把它理解成"条件指向被放大多少倍",而不是一个玄学旋钮,调起来心里就有数了:往小拉是放松约束、换取多样和自然,往大拉是收紧约束、换取贴合和锐利,中间那段,才是大多数好图的落点。
