
AI 画图的底层:扩散模型 DDPM 加噪与去噪原理拆解
文生图模型看着像"凭空"画出一张图,可它真正干的事,其实朴素得让人意外:它先把一张清晰图片一步步毁成纯噪声,再学着一路把噪声"还原"回图片。学成了还原,也就学会了生成。
这套机制的正式名字叫去噪扩散概率模型(Denoising Diffusion Probabilistic Models,简称 DDPM),是如今大多数文生图模型的底子。这篇拆它两件核心动作——加噪和去噪,看网络到底在学什么。
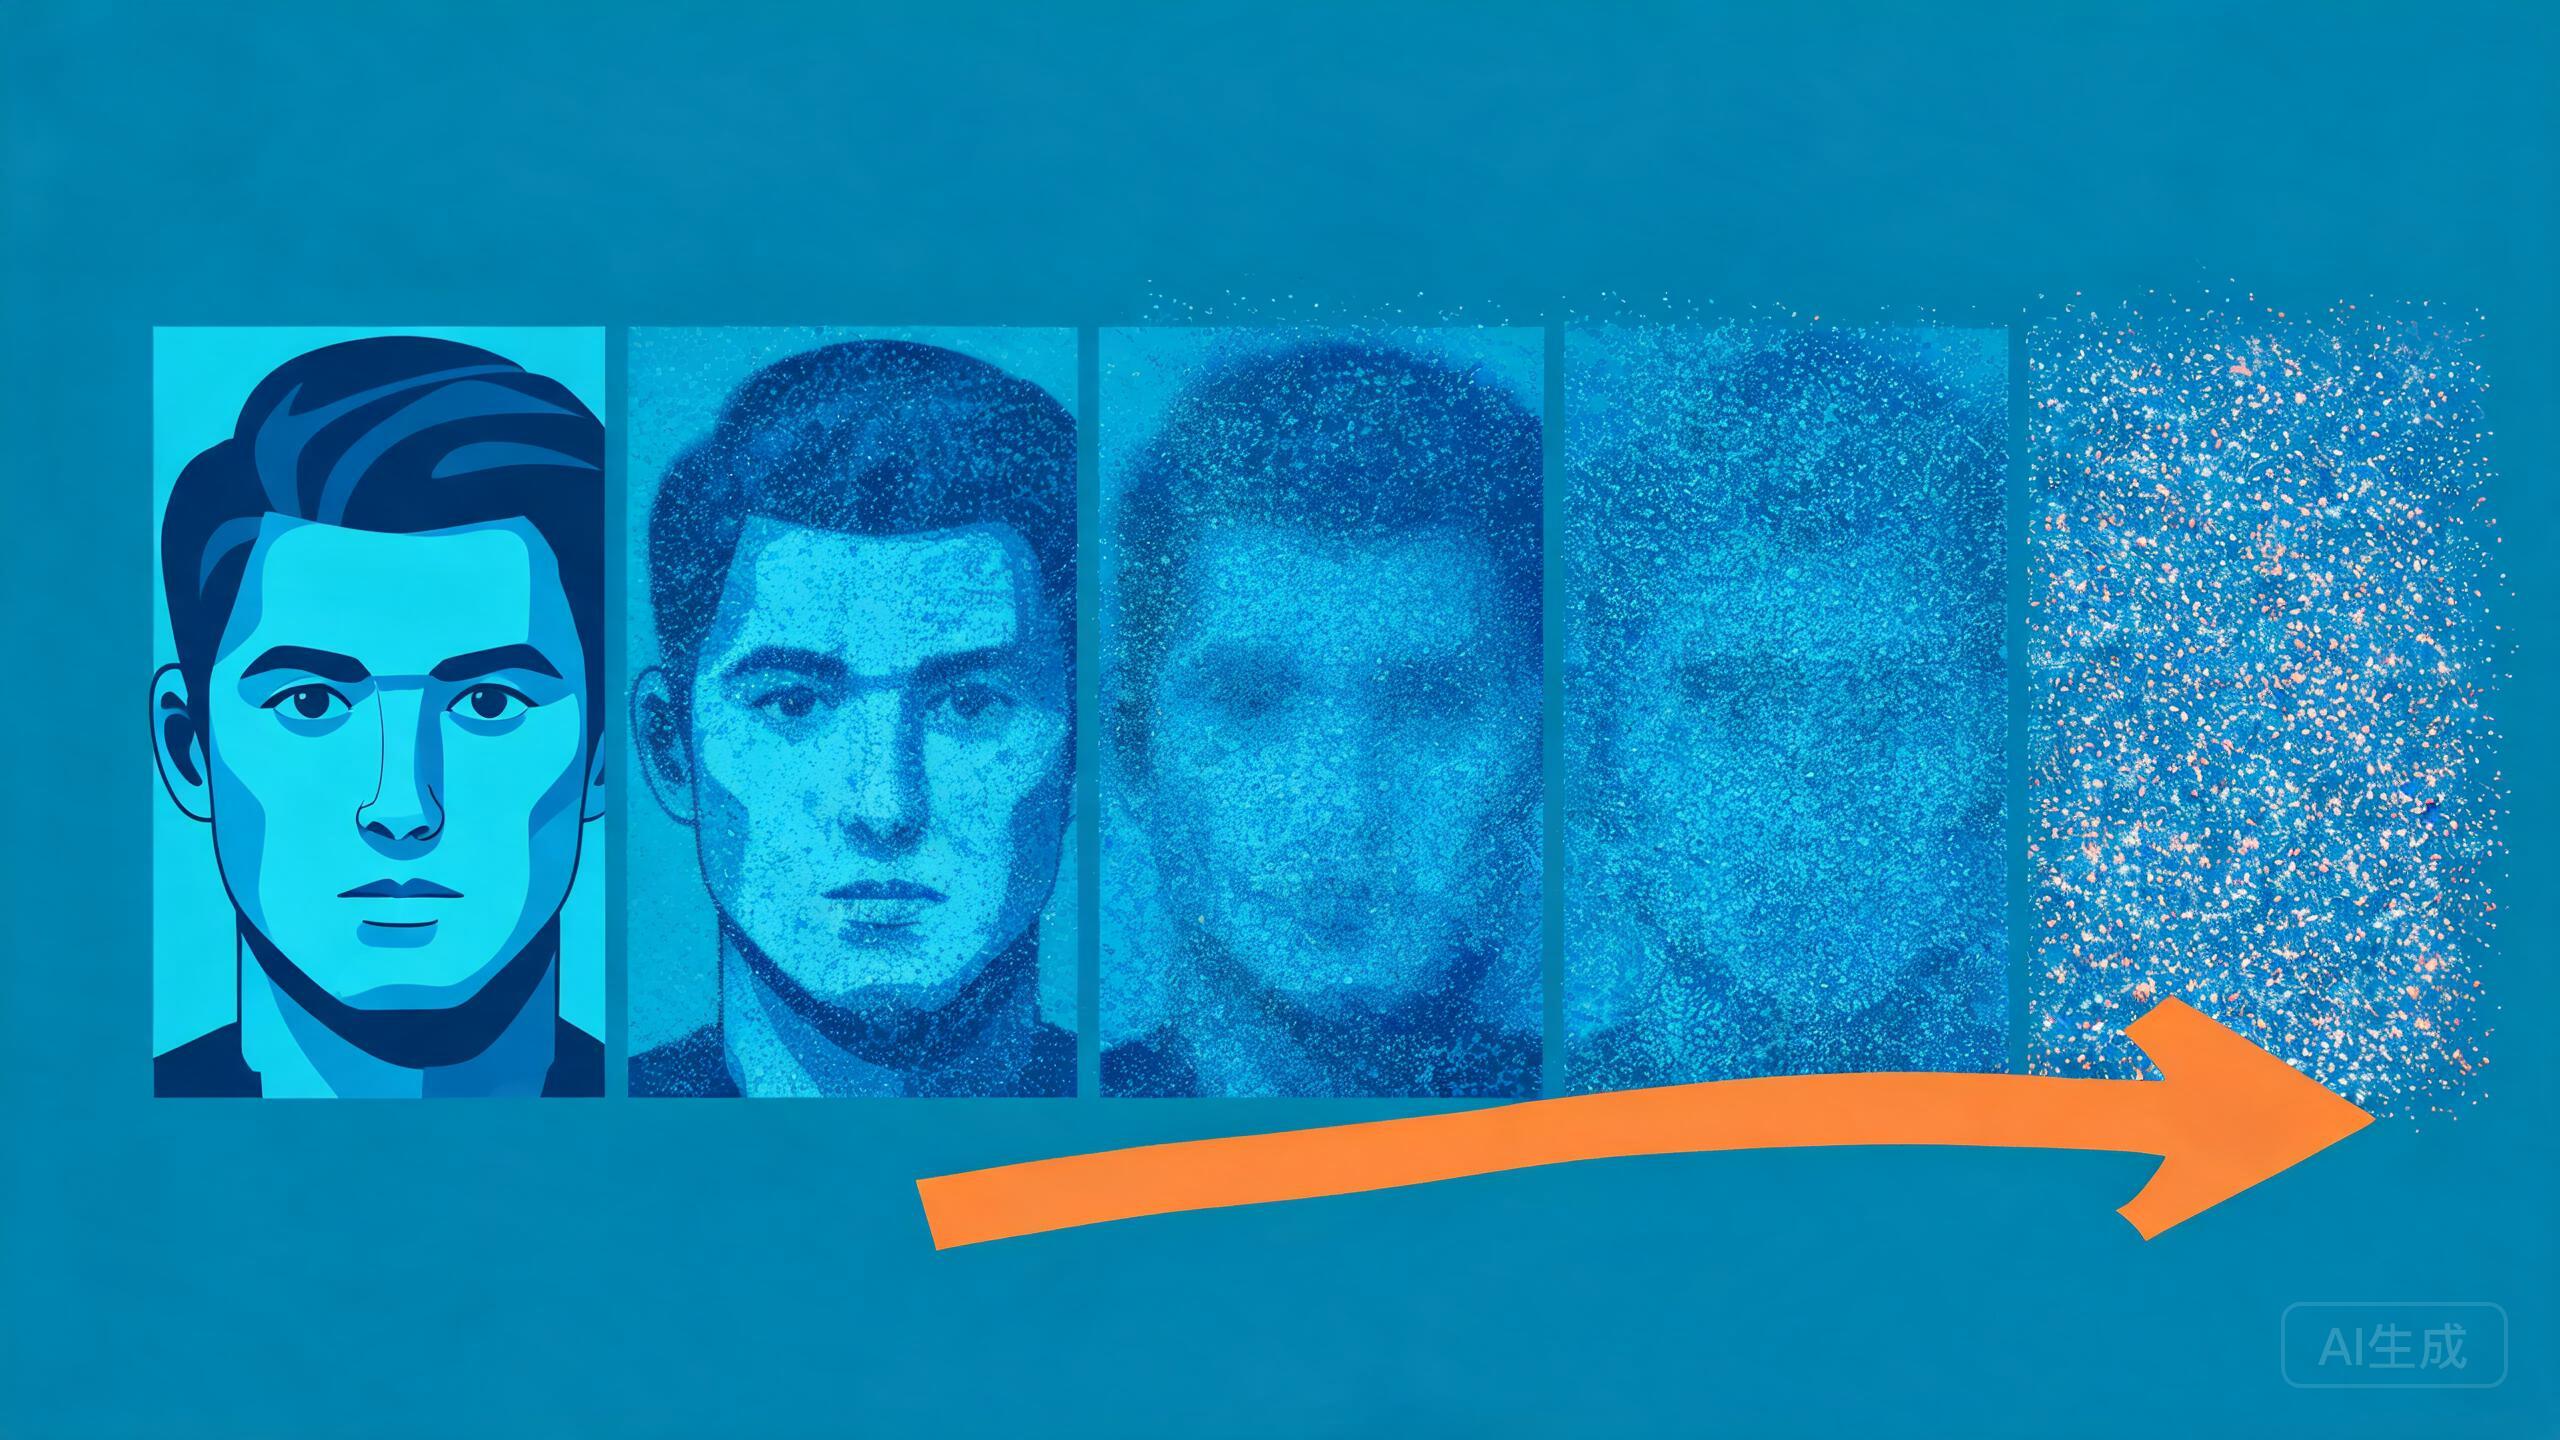
前向过程:一步步把图「泡」进噪声里
扩散模型有个前提动作,叫前向过程,简单说就是"加噪"。拿到一张清晰的图 x₀,按固定的规则,一点点往上加高斯噪声:先加一点,图还是能看清;接着再加一点,细节开始糊;加到第 T 步,原图已经消失,只剩一摊近似的纯噪声。
这个过程是人为设计好的、不需要学习的。每一步跟前一步是什么关系、加多少噪声,都由预设的参数定死,构成一条马尔可夫链——下一步只依赖上一步。
可以把它想成"往一杯清水里一滴滴滴墨水",滴到后来,水已经完全看不清,原来的清透全被覆盖。前向过程就是这样,用可控的方式,把"清晰的图"推向"纯噪声"。
逆向过程:学好「还原」,就什么都能画
真正有用的是反方向的逆向过程:从噪声出发,一步一步把噪声去掉,把图"洗"回来。
难点在于,正向加噪是定死的、好算;逆向去噪却没那么直白——光从一摊噪声,谁也不知道上一步应该是什么。于是扩散模型训练一个神经网络,专门干这件事:给它一张带噪的图,再告诉它"现在是第几步",让它预测"这张图里混了多少噪声"。
网络预测出噪声,就能从带噪图里把它减掉,得到一张更清晰一点的图。反复做 T 步,就从噪声一路走回了清晰的图片。
训练目标:一句话,学会「认噪声」
既然网络的任务是"预测噪声",训练就很好设:随机拿一张清晰图,随机挑一个时间步 t,按前向规则给它加上对应分量的噪声,得到带噪图 x_t;让网络看 x_t 和 t,输出它预测的噪声 ε_θ;再去和"真正加进去的噪声 ε"比,越接近越好。
落到损失函数,就是一个均方误差:
Loss = ‖ ε − ε_θ(x_t, t) ‖²
这里 ε 是真实加进去的噪声,ε_θ(x_t, t) 是网络根据带噪图和时间步预测出来的噪声。训练的目标,就是让这两个噪声在平均意义上贴得越来越近。模型没被要求"想象一张图长啥样",它要练的看家功夫,就是准确认出噪声。
这个设定高明在:任务被拆得特别纯粹、特别可学。认噪声这件事,无论哪张图、哪个时间步,都能构造出明确的监督信号,网络只要反复练,就能把"去噪方向"学明白。
采样时,从纯噪声里「挤」出一张图
训好的网络怎么画图?零步不走前向,直接走逆向:先随机生成一摊纯噪声 x_T,把它当成"加噪到顶的图";然后网络看它、预测噪声、去掉一部分,得到 x_{T-1};再预测、再去,一路做 T 步,落得一张"看起来像真实图片"的 x₀。
因为网络在训练时见过了各个时间步的带噪图,它知道"这种糊法该往哪个方向去噪"。于是从噪声出发,每一步都往"更像一张图"的方向挪一点,便落回数据分布里。
T 步全套走下来很慢,后来有了 DDIM 这类快速采样,跳着去噪,几步就能出一张像样的图——工程上的提速,不改变"认噪声再减掉"的底层逻辑。
文字是怎么插进来的
文生图要求按文字画,那文字在哪儿起作用?关键就在那个去噪网络。
把文本(比如"一只戴墨镜的猫")用文本编码器转成向量,作为"条件"喂给去噪网络。网络在预测噪声时,就带着这个条件一起看——它不再学"随便去噪",而是学"在'戴墨镜的猫'这个约束下去噪"。于是从同一摊噪声出发,喂不同文字,去噪方向就不同,画出的图也就不同。
这也正好接上了之前聊过的 CFG:文字引导越强,去噪越向着文字想要的方向走。扩散模型提供"从噪声还原成图"的骨架,文字条件决定"还原成什么样的图"。
小结
把扩散模型收一下:它分两步,前向是"把清晰图一步步加噪到纯噪声",逆向是"网络一步步预测噪声再减掉、还原成图";训练目标非常单纯的均方误差 `‖ε − ε_θ(x_t,t)‖²`,让网络学会认噪声;采样时从纯噪声出发反复去噪,就落回了一张真实图;文字以条件向量方式喂进去,决定去噪的方向。加噪是设计好的,去噪是学出来的——学好了去噪,就学会了生成。
一句话记住 DDPM:先用噪声毁掉画,再让模型学会把画从噪声里救回来,救得多了,它就会自己造画。
