
AI是怎么从一片噪点画出一张图的?扩散模型去噪原理拆开讲讲
刷到过AI绘画的生成过程吗?我说的是那些把生成过程录下来的视频——画面不是从草图慢慢变成成品,而是先铺满一片灰蒙蒙的噪点,然后像照片在显影液里一样,五官、轮廓、光影从噪音里一点点浮出来。我刚看到的时候挺意外:人画画是从"什么都没有"到"有点什么",AI正好反过来,它是从"全是东西"的噪点里,往外"拎"出一张图。
这个现象背后藏着一整套技术方案,圈内管它叫扩散模型。今天大部分AI绘画工具——Stable Diffusion、Midjourney——底层跑的都是这个思路。把它的原理捋清楚,你就知道屏幕上那块噪点为什么能变成画。
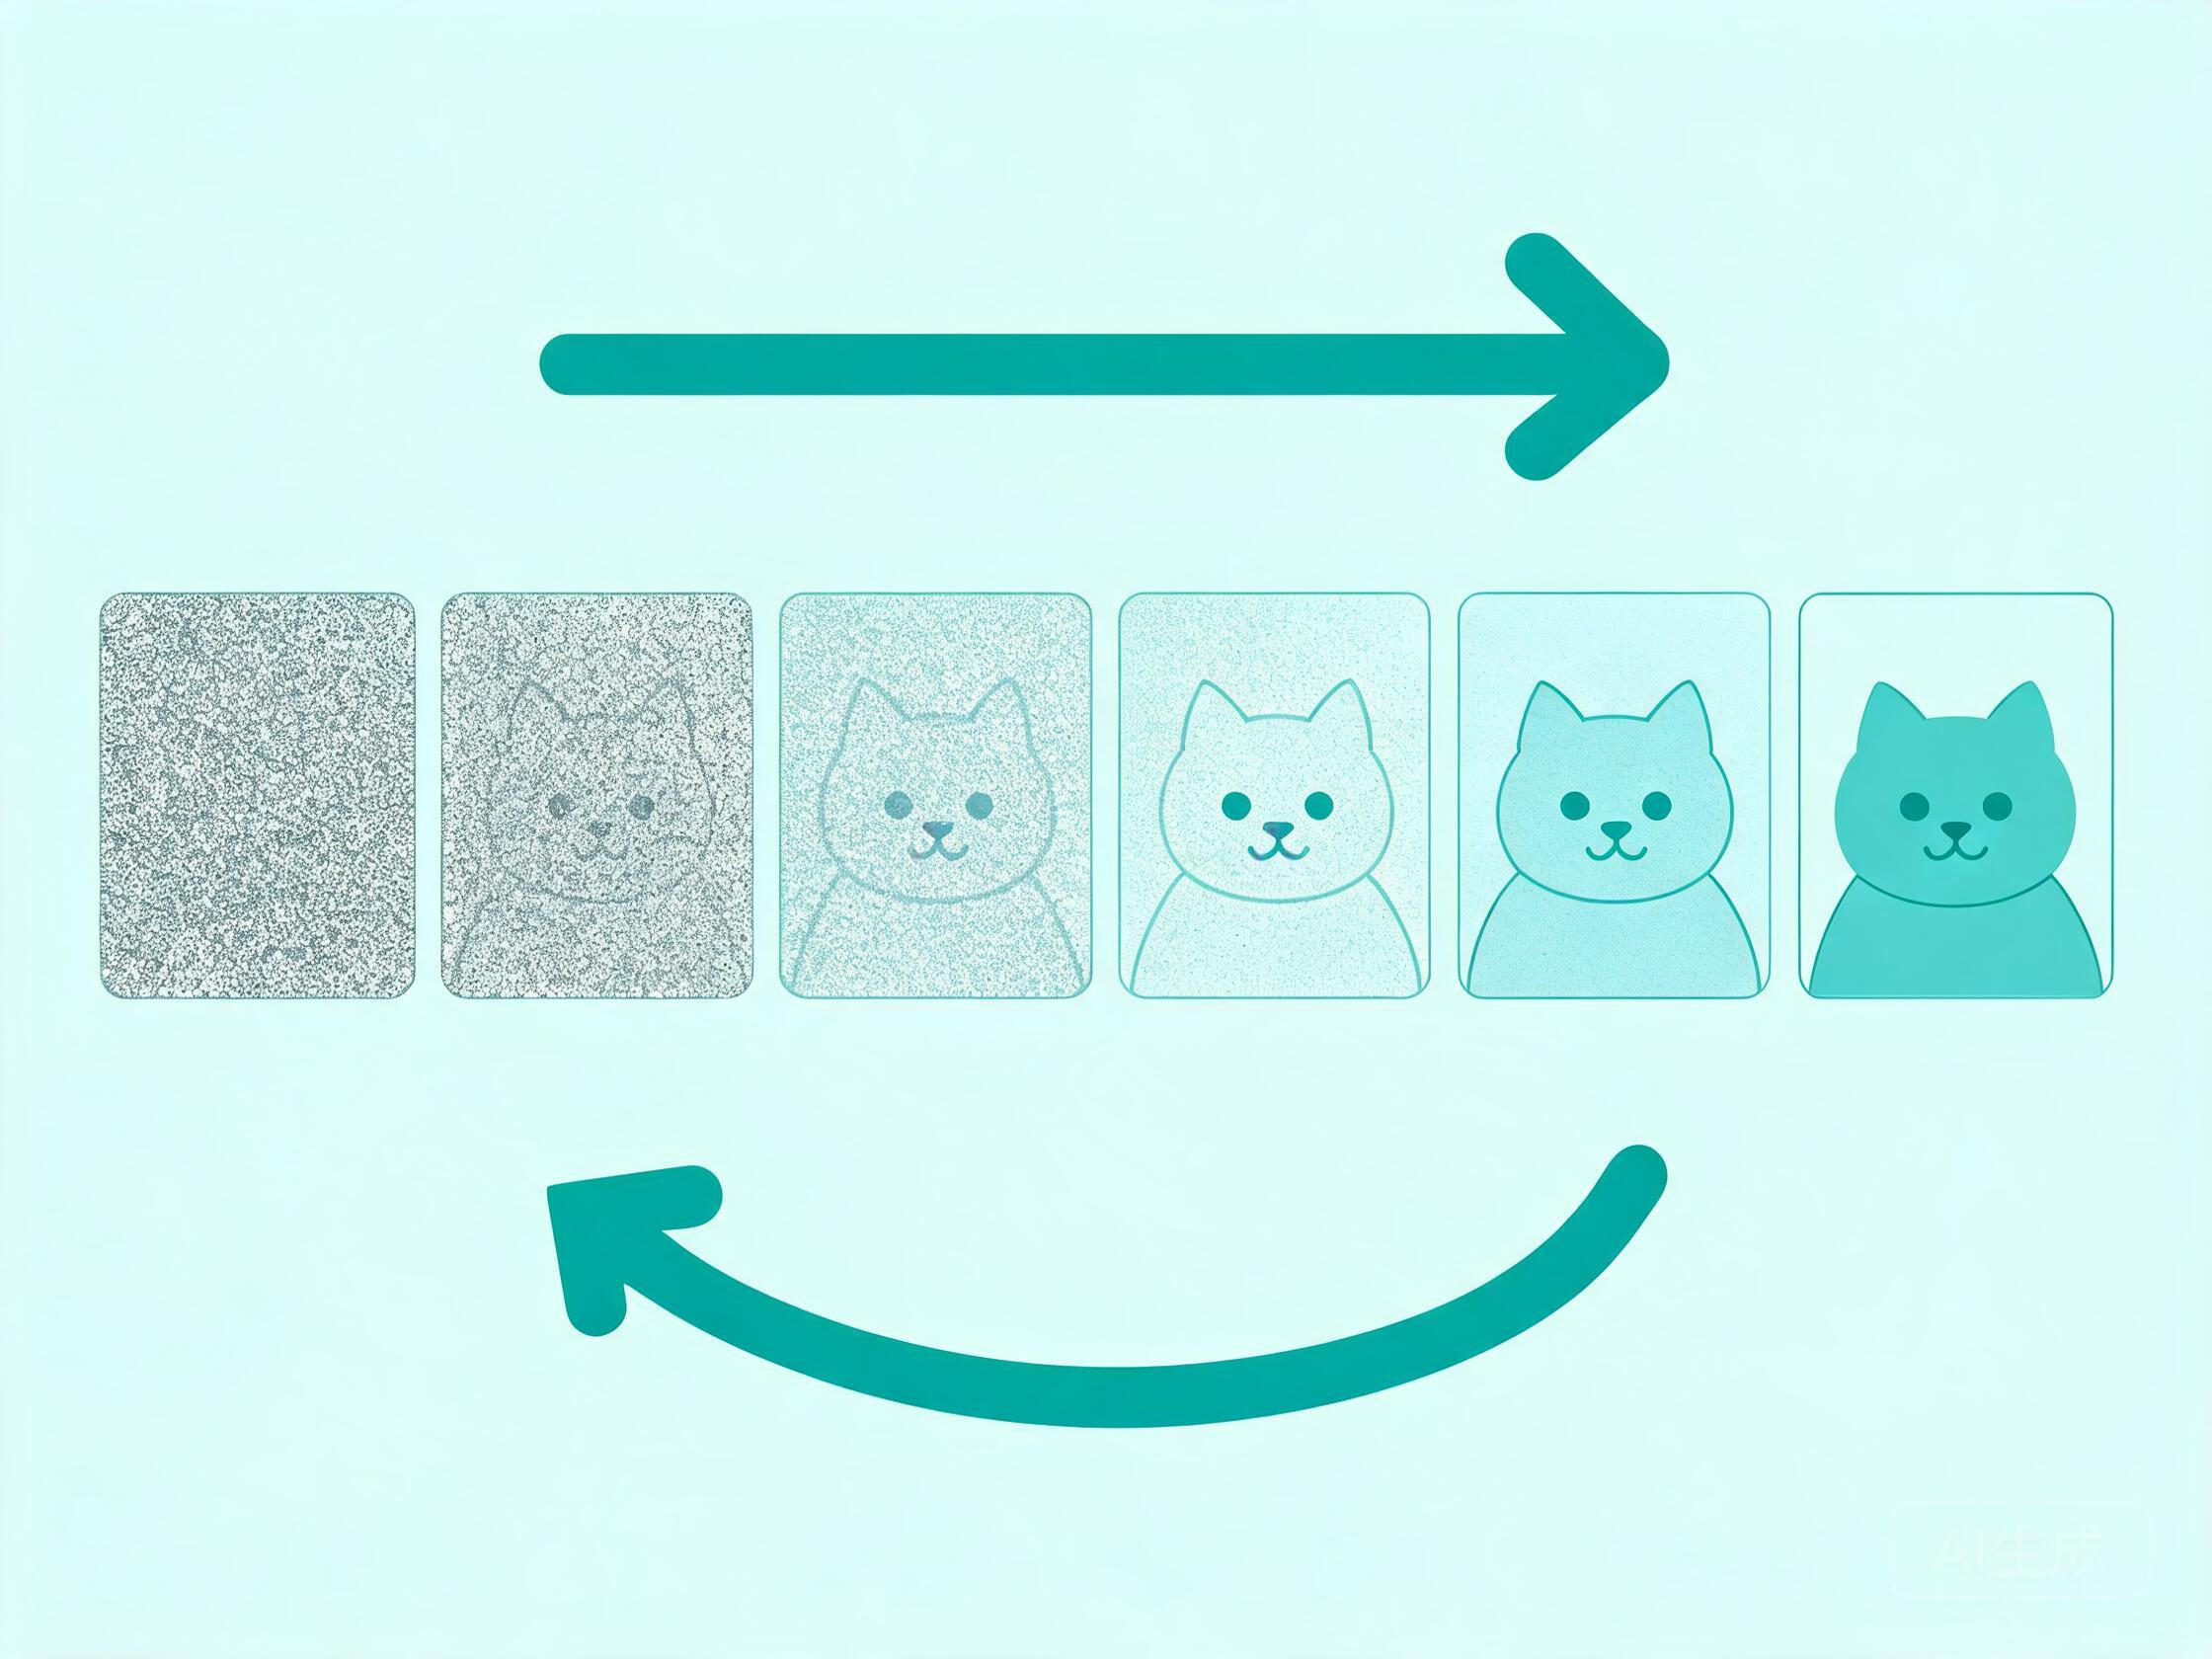
先把"加噪"这件事说清楚。训练阶段,研究者做了一件看起来挺无聊的事:把一张真实照片,一步接一步地加上随机噪声。加一点,再加密一点,直到照片完全淹没在噪点里,变成一坨没有任何形状的雪花。这个过程叫前向过程,直白地讲,就是故意把图片弄坏。弄坏很多张图之后,模型的任务就来了——给它看一张"被弄坏到某个程度"的图,让它判断刚才加进去的噪声长什么样。注意,模型学的不是"怎么画猫",而是"怎么判断噪声"。这听起来更绕,但恰恰是聪明的地方。
真正生成图片的时候,流程反着走。模型手里只有一个随机噪点,没有任何画面。它做的是反向过程:把这张噪点图里的噪声,一点一点剥掉。剥掉一层,画面就隐约浮现一点形状;再剥掉一层,轮廓清楚一些;剥到后面,细节、质感、光影都冒出来了。你看到的生成进度条,就是在跑这个过程——通常几十步,多的上百步,每一步都往"更像真实照片"的方向挪一点点。
这里有个容易误解的地方。扩散模型每一步去噪,其实都在"猜"——它根据训练时见过的海量图片,判断"一张真实照片在这个去噪程度下大概长什么样",然后按这个判断修正画面。所以同一个噪点起点,换一组随机数(种子),出来的就是完全不同的图。画里的细节——那扇窗、那只猫、那抹光——没有一样是模型"决定"要画的,全是它在去噪过程中顺势浮现出来的。
想明白这个,几个常见参数就很好懂了。步数(steps)是去噪的次数,步数太少画面糊,太多纯属浪费时间。CFG(无分类器引导)控制的是模型对提示词的服从程度——调高,画面更贴近描述,代价是可能过度锐利,看着有点"用力过猛";调低,画面更松弛自然,但也可能偏离提示词。种子(seed)是那张起始噪点的编号,换种子就是换一张噪点,等于换一个画面起点。
下次再看到AI绘画的生成视频,你就知道那块噪点不是"没画完",而是画面的起点。AI不是从零开始画,是从混沌里把图像一点一点"捞"出来——这个过程跟人画画正好相反,但一样需要几十步耐心的反复修正。
