
为什么ControlNet几十张图就能学会控姿势?零卷积与锁权重的设计拆解
1周前 (10-05)20
文生图模型早期有个很让人抓狂的槽点:画面能画出一整套,但姿势、边缘、深度这些"结构",基本靠运气。你让角色举右手,它偏举左手;你要一张建筑线稿,它给你涂成一团颜色。原因在于,提示词…
同样一句提示词,为什么有的图糊有的图艳?CFG引导强度的原理拆解
1周前 (10-05)18
用文生图工具画一张图,调参数时你多半遇到过这么个滑块:写的是"引导强度"或"CFG Scale",默认值常常卡在 7 上下。把它往小拉,画面变得发散、糊、跟提示…
模型怎么知道「我」在句子开头还是结尾?位置编码与RoPE旋转位置编码拆解
1周前 (10-05)17
"我喜欢你"和"你喜欢我",用了完全相同的三个字,意思却相反。人靠字的先后顺序读出这层区别,但 Transformer 里的注意力机制,本质上对顺序是"…
模型为什么要把句子切成碎片?BPE分词算法一步步拆解
1周前 (10-05)19
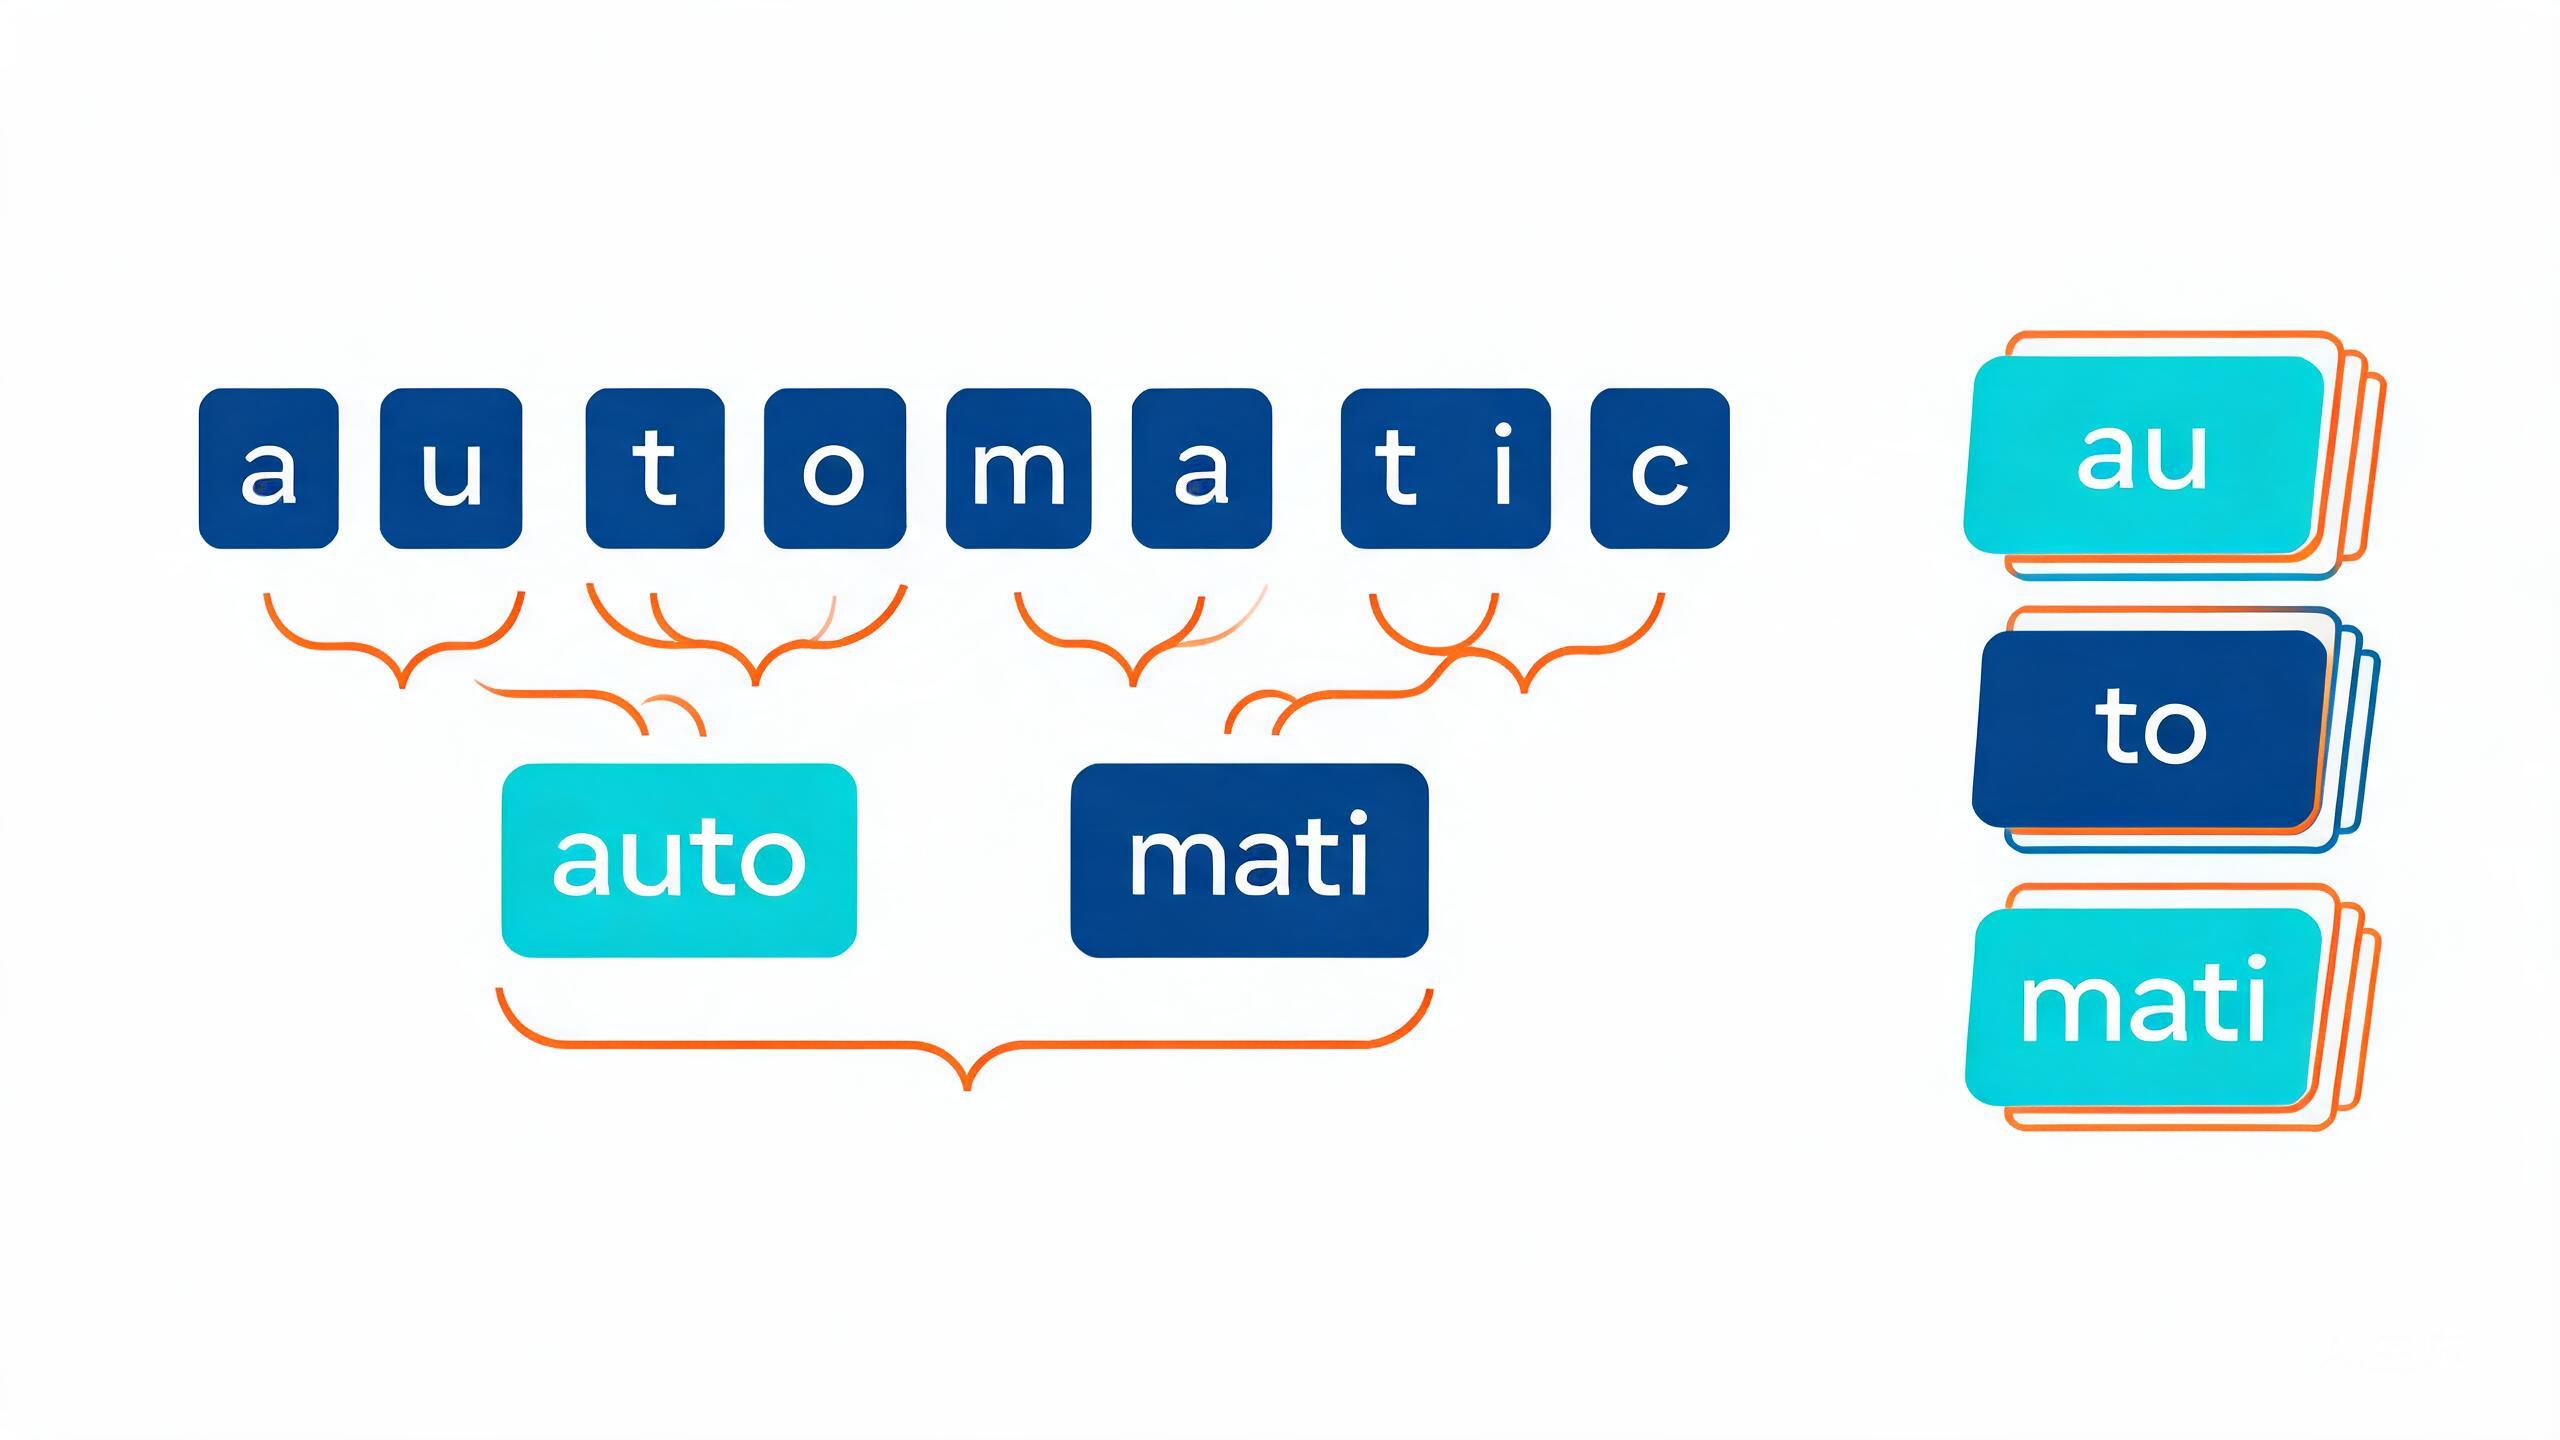
你用中文输入"今天天气不错",模型看到的并不是这六个字。它拿到手的,是一串整数——每个整数对应词表里的一个 token,而一个汉字在多数主流模型里会被拆成两到三个 token。也就…
大模型推理为什么既想快又想省显存?KV Cache的缓存账与优化拆解
1周前 (10-05)19
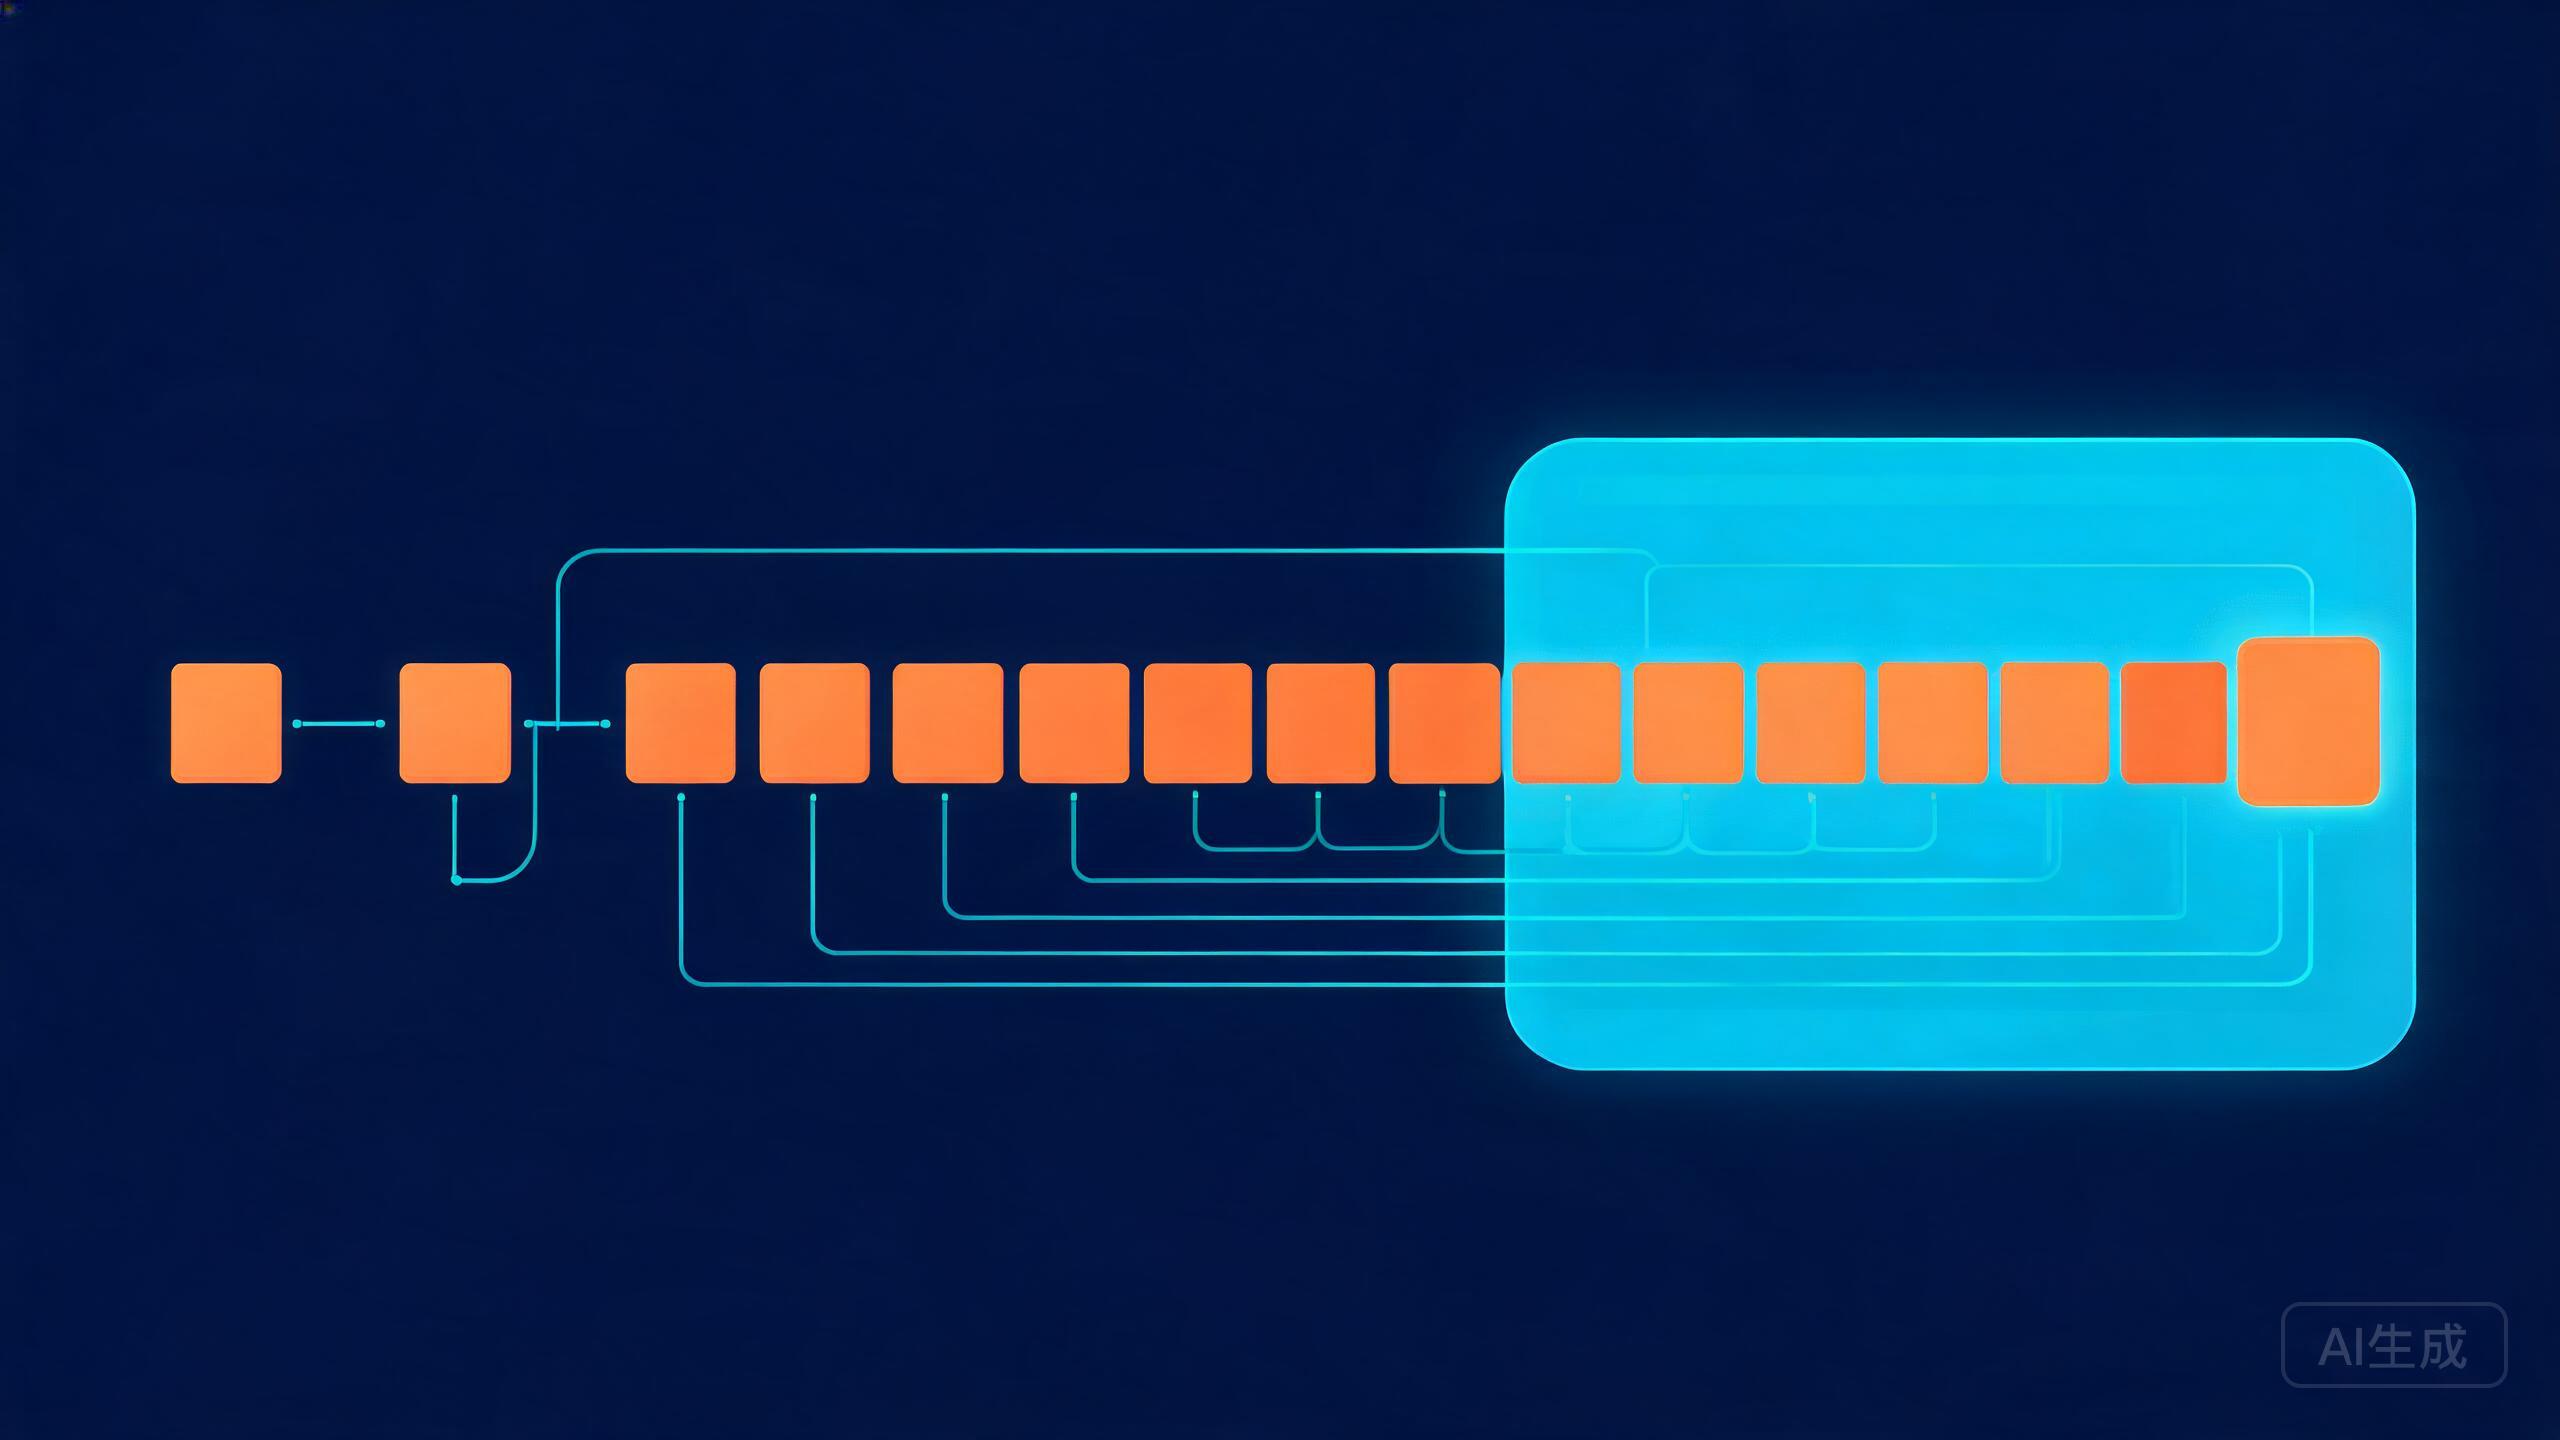
拿一个开源的 7B 模型部署对话服务,跑起来之后你会发现一个奇怪的现象:生成速度为每秒四五十个 token,显卡显存却已经吃掉了二十多 GB。按模型权重 fp16 算,7B 参数不过 14GB,剩下的…
大模型是怎么学会「说人话」的?从RLHF到DPO的偏好对齐技术演进
1周前 (10-05)17
用基础模型写一段产品介绍,你经常会得到这样的结果:语法通顺、结构工整、词藻还不差,但读起来总透着一股"不像正常人会写出来的东西"的味道。要么把一句能说完的事抻成三段,要么该收尾的地…